L'essentiel. En testant knls 0.6 sur son Cloud, France Nuage a révélé trois régressions invisibles en qualification : des network policies désarmées, 145 Mio de mémoire noyau en trop par nœud et un DNS quarante fois plus lent. Nos deux équipes ont travaillé en direct, chiffres de France Nuage à l'appui. Le jour même, en quelques heures, toute la production tournait avec un DNS médian à 5 ms, contre 8 ms avant la migration.
France Nuage, le partenaire qui challenge dès l'alpha
France Nuage fait partie de nos clients et partenaires les plus férus de technique. Quand nous sortons une nouveauté, son équipe fait partie des premières à la malmener.
Le terrain de jeu, c'est son Cloud : une plateforme Kubernetes moderne et complexe, avec beaucoup de services et beaucoup de network policies. Pas un banc d'essai, la vraie vie. Exactement l'endroit où un logiciel réseau montre ce qu'il vaut, sous l'œil d'une équipe qui mesure tout, tout le temps.
La règle du jeu : travailler en synchrone. France Nuage déploie, observe et nous envoie ses chiffres. Nous corrigeons dans la foulée et renvoyons un build. En face : Mikaël, notre CTO, qui se trouve aussi être l'auteur de knls.
Tout s'est joué dans la même journée, en quelques heures au total. À la moindre alerte, retour immédiat à la version précédente, le temps de comprendre : c'est ce qui permet de tester en conditions réelles sans faire subir l'expérience aux utilisateurs.
knls, c'est quoi, et pourquoi on y tient
knls (Kubernetes Node-Local Services) est un logiciel libre qui tourne sur chaque nœud d'un cluster. Il y assure les services réseau locaux : le rôle de kube-proxy via nftables, un DNS autoritaire, la connectivité entre pods via WireGuard et l'application des network policies.
Il est écrit en pur Rust, avec une obsession : ne rien gaspiller. Les ressources qu'un composant système consomme sont autant de ressources retirées à vos applications, sur chaque nœud.
- 7 Mo de binaire en mémoire ;
- environ 10 Mo de RSS sur un cluster vide ;
- 80 Mo sous un test de charge à 8 000 services.
La version 0.6 pousse cette logique un cran plus loin. Jusque-là, knls préparait ses règles de pare-feu puis les confiait à nft, la commande standard de nftables. Désormais, il parle netlink directement, c'est-à-dire le protocole par lequel un programme dialogue avec le noyau Linux. Plus de processus externe à lancer, donc plus de pic de mémoire à chaque changement de règles.
Le prix à payer : toutes les subtilités que nft gérait en silence deviennent les nôtres. On en a rencontré trois.
Premier écueil : l'erreur qui accusait le mauvais coupable
Premier essai, premier retour arrière au bout de quelques minutes. Sur les nœuds, le noyau rejette certains ajouts d'éléments dans un set (un ensemble d'adresses) avec l'erreur EINVAL. Or un lot nftables est atomique : un seul message refusé, et tout le lot est annulé.
Résultat : la chaîne de filtrage des pods reste vide, les network policies ne s'appliquent plus, et knls réessaie en boucle, 60 à 80 fois par minute. Rien de tel en qualification, qui compte beaucoup moins de policies.
Le message d'erreur désigne un set d'adresses tout à fait banal. Mikaël soupçonne d'abord un problème de taille, sans trop y croire : knls charge sans broncher des sets bien plus gros. Quelques essais plus tard, il reproduit le cas, et le suspect est innocenté.
Le vrai coupable est ailleurs. knls envoie ses messages au noyau par transactions de 1 024. Parmi eux, des sets anonymes, utilisés pour les plages de ports. Chez France Nuage, le remplissage de l'un d'eux tombait pile à cheval sur deux transactions, et le noyau n'apprécie pas du tout.
La qualification ne pouvait pas le voir : avec moins de policies, la frontière des 1 024 messages ne tombait jamais au mauvais endroit. France Nuage avait conservé les messages rejetés complets, ce qui a rendu la reproduction rapide. Correctif livré dans la foulée : la version 0.6.1 part en production.
L'après-midi en direct, acte 1 : la mémoire noyau
La 0.6.1 est déployée, et France Nuage remonte aussitôt un chiffre qui pique : la mémoire noyau non récupérable de ses nœuds a pris 145 Mio. Sur l'un d'eux, les règles nftables pèsent 172 Mi contre 29 Mi auparavant.
L'explication tient en une phrase. La 0.6 exprime les network policies avec des sets, ce qui est le bon outil, mais elle créait un set par règle. Quand de nombreuses policies visent les mêmes pods, le noyau stockait autant de copies du même ensemble d'adresses.
Mikaël avait déjà le correctif en relecture : factoriser les sets par sélecteur plutôt que par règle. Un même sélecteur donne un seul set, référencé partout où il sert. Chez France Nuage, cela donne 48 sets pour 275 références.
Vingt-deux minutes après le déploiement de la 0.6.1, un premier build alpha tourne sur un nœud. Le surcoût mémoire tombe de +145 Mio à +15 Mio.
Acte 2 : le DNS qui hoquette
Reste un souci, et pas des moindres. Depuis la migration, la sonde de France Nuage voit la résolution DNS médiane passer de 8 ms à plus de 300 ms.
Première mesure, en interrogeant knls directement, une requête par seconde. Sur 50 requêtes, la médiane est à 0 ms, mais 9 sont plus lentes et 3 dépassent 100 ms, avec un maximum à 312 ms. Le DNS n'est donc pas lent : il hoquette. Quelque chose lui vole la main par moments.
Ce quelque chose, c'est notre propre progrès. En 0.5.6, l'application des règles était faite par nft, un processus séparé. En 0.6, ce travail se fait dans knls : beaucoup moins de gaspillage, mais un calcul qui occupe le processeur assez longtemps pour gêner tout ce qui partage le même moteur asynchrone. Et la mise à jour des zones DNS s'exécutait en série avec le répondeur.
Tant que ce calcul était court, personne ne voyait rien. Sur une production de cette taille, il ne l'était plus.
Le correctif arrive en deux temps :
- Séparer la mise à jour des zones du répondeur DNS. La médiane redescend à 30–61 ms. Mieux, mais encore irrégulier.
- Donner à chaque grande fonction ses propres threads (proxy, DNS, connectivité). La médiane tombe à 5 ms.
Au passage, Mikaël peste contre lui-même en plein correctif :
« Tssss, ça va me faire une allocation de 512 octets par requête (oui, je pars de loin). »
Quand on se reproche 512 octets, c'est qu'on a pris l'habitude de compter.
La preuve par la charge : pendant un test de bout en bout qui crée 8 000 services, le thread chargé de nftables monte à 80 % de processeur. Le DNS, lui, ne montre aucun pic.
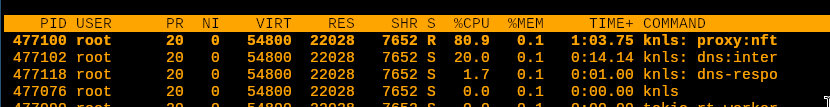
top -H -p $(pidof knls) montre qui consomme quoi.Le résultat, chiffres de France Nuage à l'appui
Trois heures et vingt minutes après le constat, le second build alpha tourne sur un nœud. Moins d'une heure plus tard, il est déployé sur toute la production. Voici le tableau de suivi que France Nuage nous a transmis :
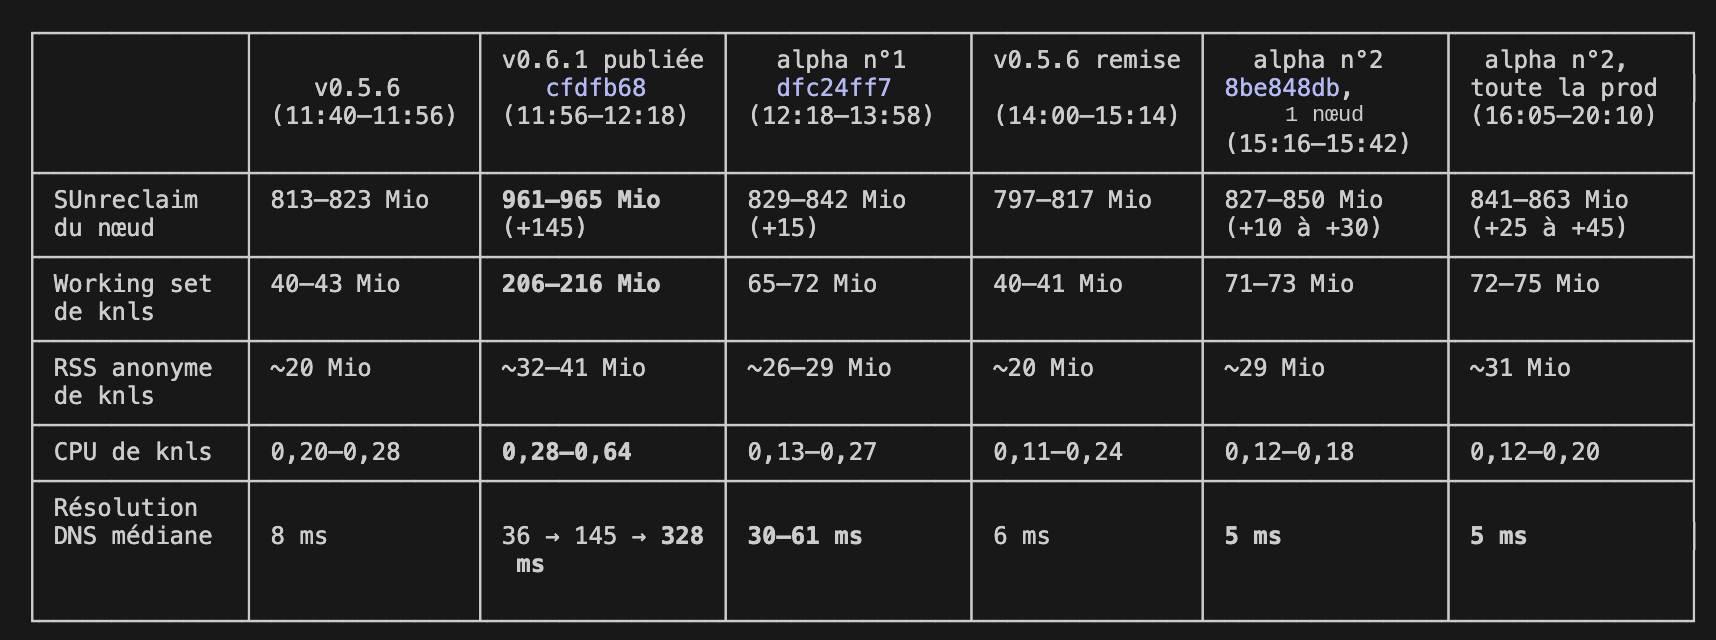
En résumé, entre le point de départ et l'arrivée :
| Mesure | knls 0.5.6 | knls 0.6.1 publiée | Alpha n°2, toute la production |
|---|---|---|---|
| Résolution DNS médiane | 8 ms | jusqu'à 328 ms | 5 ms |
| CPU de knls (cœurs) | 0,20–0,28 | 0,28–0,64 | 0,12–0,20 |
| Surcoût de mémoire noyau par nœud | référence | +145 Mio | +25 à +45 Mio |
| Mémoire de knls (working set) | 40–43 Mio | 206–216 Mio | 72–75 Mio |
Un mot d'honnêteté sur la mémoire : knls consomme une trentaine de Mio de plus qu'en 0.5.6. Synchroniser la table avec le noyau suppose de la garder en mémoire. C'est un compromis assumé, en échange d'un processeur moins sollicité, d'un DNS plus rapide et de la fin des pics de mémoire à chaque changement de règles.
Ce qu'on en retient
Certains bugs n'existent qu'à l'échelle. Une frontière à 1 024 messages, des sets dupliqués, un calcul qui devient long : aucun ne se déclenche sur un petit cluster. La qualification reste indispensable, mais elle ne remplace pas une vraie production.
Un partenaire qui mesure vaut de l'or. Messages rejetés conservés, mémoire suivie nœud par nœud, sonde DNS en continu, tableau comparatif version par version. Chaque correctif a été validé par ses chiffres, pas par les nôtres. Merci à l'équipe de France Nuage.
La boucle courte change tout. Constat, correctif, build alpha, nouvelle mesure, et on recommence. Cette boucle ne tient en quelques heures que parce que nous écrivons les briques que nous opérons, jusqu'au dialogue avec le noyau. Comme le dit Mikaël : même en tout asynchrone, il reste des pièges. Autant que ce soit l'auteur du code qui tombe dedans.
C'est notre métier chez NOVIT : déployer et exploiter des plateformes Kubernetes, sur votre infrastructure ou sur des machines dédiées, et prendre pour nous la partie difficile. Si votre réseau, votre DNS ou vos nœuds vous réservent ce genre de surprises, parlons-en.
Questions fréquentes
Qu'est-ce que knls ?
knls (Kubernetes Node-Local Services) est un logiciel libre écrit en Rust qui fournit, sur chaque nœud Kubernetes, le rôle de kube-proxy via nftables, un DNS autoritaire, la connectivité des pods via WireGuard et l'application des network policies. Son code est disponible sur GitHub.
Pourquoi piloter nftables en netlink plutôt qu'avec la commande nft ?
Pour éviter de lancer un processus externe à chaque changement, ce qui provoque des pics de mémoire. La contrepartie : il faut gérer soi-même les règles du protocole, comme les limites de transaction.
Pourquoi une erreur sur un set nftables peut-elle annuler toutes les règles ?
Parce qu'un lot nftables est atomique. Si un seul message est rejeté par le noyau, tout le lot est annulé, y compris les règles sans rapport avec l'erreur.
Pourquoi un bug réseau Kubernetes n'apparaît-il qu'en production ?
Souvent à cause d'un effet d'échelle : il faut assez de services et de network policies pour dépasser un seuil que la qualification n'atteint jamais.
Combien de mémoire consomme knls ?
Environ 10 Mo de RSS sur un cluster vide et 80 Mo sous un test de charge à 8 000 services, pour un binaire de 7 Mo en mémoire.